
API für Datenextraktion in Sekundenschnelle

Automatisieren Sie Ihre Datenextraktion mit einer API, die KI und adaptives Layoutverständnis nutzt, um Daten präzise aus unstrukturierten Dokumenten zu extrahieren.
Senken Sie Ihre Prozesskosten um bis zu 95 % und verbessern Sie gleichzeitig die Datenqualität.
Jetzt kostenlos testen!


4.8/5 (30+ Bewertungen)

Weltweit von Top-Teams genutzt

Wie automatisiert APIs zur Dokumentendatenextraktion funktionieren?

1
Erfassung

2
Vorverarbeitung

3
Datenextraktion

4
Anreicherung

5
Validierung
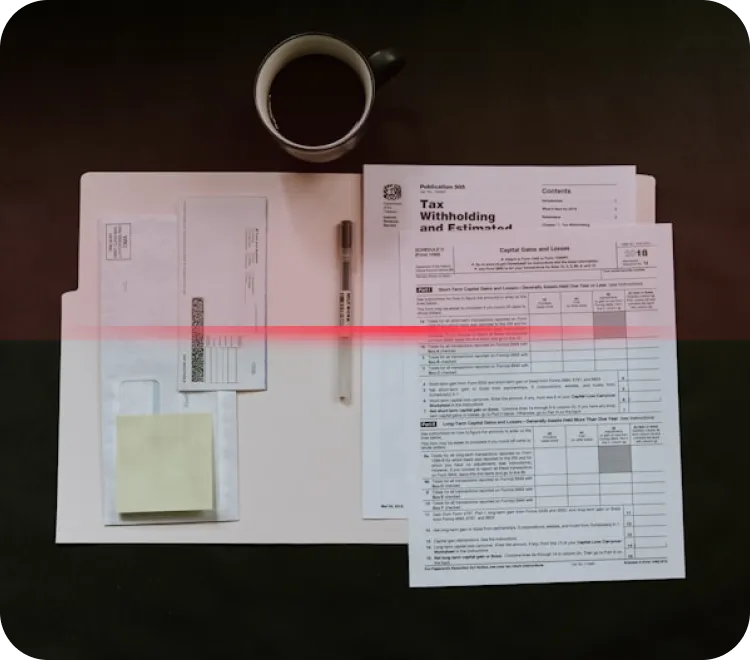
Konvertiert Handyfotos von schlechter Qualität und handschriftliche Notizen in native PDF-Dateien.
Die Mindee API bereinigt unscharfe Handyaufnahmen, analysiert Handschrift und isoliert mehrere Dokumente auf einer einzelnen Seite bzw. einem einzelnen Bild.

Auto-Crop

Live-Test verfügbar

KI-gestützte Klassifizierung, die Dokumenten-„DNA“ (Rechnungen vs. Verträge) erkennt und die Stapelverarbeitung automatisiert.
Manuelle Dokumentensortierung gehört der Vergangenheit an. Unsere Routing-Engine fungiert als digitaler Architekt, klassifiziert Dokumente in Echtzeit und leitet sie an die korrekte Geschäftslogik weiter.


Extrahiert Daten aus beliebigen Layouts mit herausragender Genauigkeit: Komplexe Tabellen, Schlüssel-Wert-Paare und handschriftliche Anmerkungen werden unterstützt.
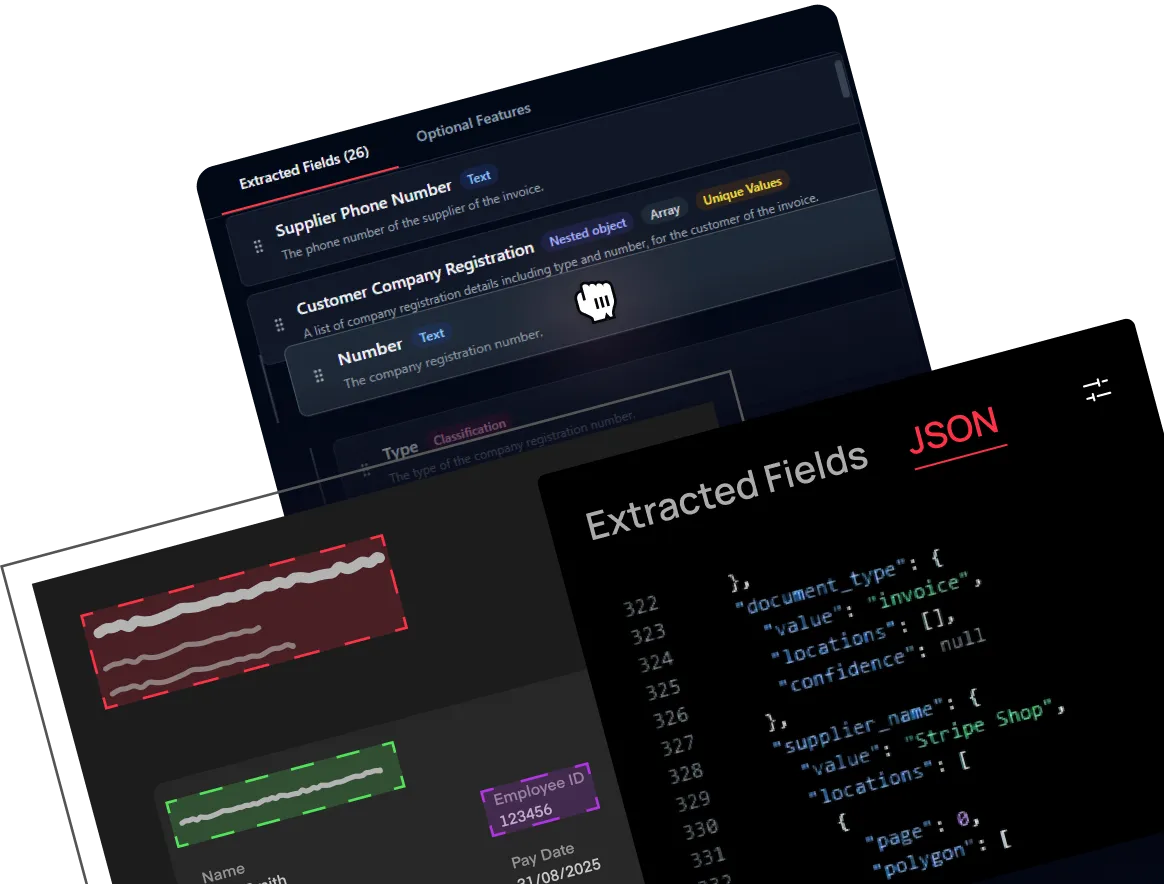
Mehr als einfache Zeichenerkennung. Unsere Extraktionsschicht nutzt neuronale Netze, um Ihre Daten kontextbezogen zu verstehen und statische, unstrukturierte Dateien in dynamische, strukturierte Assets im Standard-JSON-Format umzuwandeln.


Echtzeit-Synchronisierung mit ERP/CRM-Stammdaten und automatisierte API-Validierung von Drittanbietern (USt-IdNr., Compliance)
Isoliert betrachtete Daten sind nur bedingt aussagefähig. Die "Enrich"-Phase schließt dank Integrationen die Lücke zwischen einem Dokument und Ihrem gesamten Unternehmensökosystem (ERP, CRM, PLM).


Automatisierte Validierung von Geschäftsregeln und hocheffiziente Human-in-the-Loop-Workflows für die Validierung von Ausnahmefällen.
Gehen Sie über einfache Extraktion hinaus. Erstellen Sie belastbare Dokumenten-Pipelines, die Daten automatisch anhand Ihrer individuellen Geschäftsregeln überprüfen. Unsere API verwaltet die Schnittstelle zwischen automatisierten Konfidenzscores und menschlicher Sonderfallvalidierung – und stellt so sicher, dass Ihre Produktionsdaten stets sauber, konform und nutzbar sind.

Konfidenzwerte

Enterprise-fähig
Mindee API-Funktionen zur Reduzierung von Zeitverschwendung bei der Dokumentenverarbeitung

Benutzerdefinierte Extraktionsmodelle
Nutzen Sie unsere vorgefertigten Modelle und passen Sie das Datenschema an oder erstellen Sie alles von Grund auf neu.

Mehrsprachig, mehrere Formate/Sprachen
Verarbeiten Sie alle Dokumenttypen (PDFs, JPEG, PNG usw.) und geben Sie strukturierte Daten im JSON-Format zurück.

Erweiterte OCR-Funktionen
Konfidenzwerte, kontinuierliches Lernen zur Modelloptimierung und Begrenzungsrahmen verfügbar.

Live-Test verfügbar
Testen Sie Ihre Modellkonfiguration live in der Mindee-App. Aktualisieren Sie Ihr Modell unterwegs mit unserem KI-Assistenten.
SDKs/No-Code-Integrationen
Sofortiger Nutzen dank unserer SDKs und No-Code-Tools für Entwickler.

Sicherheit auf Enterprise-Niveau
Speichern Sie Ihre Daten dort, wo Sie sie benötigen (EU oder USA), und profitieren Sie von unseren SOC 2 Typ II-zertifizierten APIs.

Gebrauchsfertige Extraktionsmodelle
Vermeiden Sie manuelle Dateneingabe und verbessern Sie gleichzeitig Datengenauigkeit und -qualität
Mit einer intelligenten, auf Genauigkeit ausgelegten Engine beseitigen Sie manuelle Engpässe. Durch die Kombination von layoutbewusstem Parsing und Begrenzungsrahmen extrahieren wir hochpräzise Daten aus jedem Format. Die Mindee API bietet darüber hinaus Konfidenzwerte für jedes extrahierte Feld. So können Sie automatisierte Workflows sicher einrichten und gewährleisten, dass jede Information anhand Ihrer spezifischen betrieblichen Anforderungen überprüft wird.


Intelligente Extraktion von Text, Objekten und Tabellen
Extrahieren Sie Daten aus komplexen Layouts: Tabellen, Posten, handschriftliche Details, Bilder…
Verwandeln Sie unübersichtliche oder komplexe Eingaben in strukturierte Informationen. Unabhängig davon, ob es sich um strukturierte, semi-strukturierte oder völlig unstrukturierte Dokumente handelt – die Mindee API stellt eine präzise Klassifizierung der Daten sicher.Von PDFs bis hin zu niedrigauflösenden Scans extrahieren wir mühelos kritische Schlüssel-Wert-Paare, komplexe Tabellen und Posten. Durch die Kombination robuster Parser und vorkonfigurierter Modelle mit individueller Anpassung für Ihre spezifischen Dokumente überbrücken wir die Lücke zwischen Rohdaten und nutzbaren Informationen
Kontinuierliches Lernmodell
Trainieren und passen Sie Ihr Extraktionsmodell an, um jeden Sonderfall zu meistern.
Beherrschen Sie die Komplexität nicht-standardisierter Dokumente mit einer Architektur, die auf maximale Anpassungsfähigkeit ausgelegt ist. Unsere Plattform geht über statische Extraktion hinaus und nutzt kontinuierliches Lernen, um die Performance zu verfeinern.
Durch die Integration von RAG (Retrieval-Augmented Generation) können Sie Dokumente hochladen, um eine dynamische Wissensdatenbank aus vergangenen Korrekturen und spezifischen Geschäftskontexten zu erstellen. So werden selbst die ungewöhnlichsten Sonderfälle präzise behandelt – seltene Ausnahmen werden durch einen selbstverbessernden Feedbackloop zu standardisierten, automatisierten Erfolgen.


Eine Plattform, totale Kontrolle
Advanced OCR features and more to give you full control about your extraction workflow
Innovative OCR-Funktionen und mehr für volle Kontrolle über Ihren Extraktionsworkflow. Unsere Plattform bietet detaillierte Konfidenzwerte und präzise Begrenzungsrahmen, um sicherzustellen, dass jede Extraktion sowohl verifizierbar als auch strukturell korrekt ist und weit über einfache „Black-Box“-Verarbeitung hinausgeht.
Optimieren Sie Ihre Compliance-Strategie mit lokalisierten Verarbeitungszonen und einer strikten Aufbewahrungsrichtlinie („Daten werden nicht gespeichert“).
Die nahtlose Integration der Features in die von den Teams genutzten Tools gewährleistet die notwendige architektonische Kontrolle, um komplexe Dokumentenworkflows in sichere, hochpräzise automatisierte Assets zu verwandeln, die auf Ihre spezifischen Bedürfnisse zugeschnitten sind.

Rechnungs-OCR
Extrahiert Einzelposten und Summen aus globalen Rechnungen in jeder Sprache und jedem Format

OCR für Belege
Extrahiert Einzelbeträge, Steuern und Händlerdetails aus Belegen in jedem beliebigen Format

Pass-OCR
Erfasst Identitätsdaten, MRZ und Ablaufdaten von jedem internationalen Reisepass

Lebenslauf OCR
Analysiert Fähigkeiten, beruflichen Werdegang und Kontaktinformationen aus verschiedenen Lebensläufen und CV-Strukturen

Kontoauszug OCR
Digitalisiert Transaktionen, Salden und Kontodetails aus mehrseitigen Kontoauszügen

Führerschein-OCR
Extrahiert Lizenznummern, Klassen und Adressen aus verschiedenen regionalen Formaten.

Integrieren Sie Mindee in wenigen Minuten in Ihren Workflow mit SDKs und No-Code-Tools
Starten Sie innerhalb weniger Minuten live mit unserer verifizierten Zapier- und Make.com-App – ganz ohne Programmierung – oder integrieren Sie Mindee nahtlos über unsere gut dokumentierte REST-API für Entwickler. SDKs sind für Python, Node.js, Java, Ruby und PHP verfügbar.


Entwickler und technische Profile haben es bereits genutzt!
Integrieren Sie die moderne KI-basierte Mindee OCR API in wenigen Minuten in Ihr Produkt.


Mindee ist eine integrierte Plattform zur Dokumentenverarbeitung, die auf zuverlässiger KI-Technologie basiert. Der Dienst verfügt über eine intuitive, benutzerfreundliche Oberfläche und liefert hochpräzise Ergebnisse bei der Datenextraktion aus verschiedensten Dokumententypen, insbesondere aus Finanzbelegen und Rechnungen, die aufgrund ihrer Komplexität spezialisierte OCR-Verfahren (optische Zeichenerkennung) erfordern. Dank anpassbarer APIs lässt sich die Plattform nahtlos in unsere bestehenden Datenverarbeitungsprozesse integrieren und ermöglicht so eine effiziente Datenextraktion sowie Automatisierung.

Amar A.

Mindee ist eine Software, die uns dabei unterstützt, physische Geschäftsunterlagen, wie Rechnungen, Garantiekarten, Kalendereinträge und Quittungen – in digitale Dokumente umzuwandeln. Diese lassen sich auf einem Laufwerk speichern und in verschiedene Excel-Formate übertragen, sodass das Finanzteam alle Aktualisierungen pflegen und eine fundierte Analyse der Transaktionen durchführen kann.
Shiv K.
Mindee ist ein webbasiertes Tool, das uns beim Scannen und Auslesen verschiedener Dokumentenarten, wie etwa Personalausweise, Rechnungen oder Angebotsunterlagen – unterstützt. Mithilfe von KI werden alle relevanten Informationen extrahiert und anschließend strukturiert bereitgestellt.
Gaurav K.
Hervorragend. Zusätzlich zur sehr hohen Produktqualität konnten wir auf das proaktive Vertriebsteam zählen, das uns geholfen hat, das Maximum aus der Lösung herauszuholen. Es war, als hätten wir einen zusätzlichen Produktmanager an unserer Seite.

Jeff B.
Mindee arbeitet zuverlässig und liefert eine hervorragende Leistung. Die OCR-Daten sind präzise und die API ist stabil. Es funktioniert einwandfrei.
Manuel B.

Mir gefällt die einfache Handhabung und wie intuitiv es sich bedienen lässt. Auch das Preismodell ist sehr fair. Ein gutes Produkt mit noch etwas Luft nach oben.
Simon

Monatliche Verarbeitung von 15 Millionen Dokumenten. Extrahieren Sie daten in großem Maßstab.
Beginnen Sie
+500 aktive Nutzer
14 Tage kostenlose testen
Keine Kreditkarte

FAQ zur OCR-API von Mindee
Ist eine Dokumentenextraktions-API dasselbe wie eine Web-Scraping-API?

Nein. Zwar dienen beide dazu, Daten zu extrahieren, doch die zugrundeliegenden Technologien unterscheiden sich grundlegend.
- Web-Scraping-APIs sind darauf ausgelegt, durch DOM-Strukturen zu navigieren, CAPTCHAs zu umgehen und Daten aus HTML/CSS zu erfassen; sie suchen gezielt nach den gewünschten Informationen, bevor die Extraktion erfolgt.
- APIs zur Datenextraktion (Document AI) wurden speziell für die Verarbeitung „unstrukturierter visueller Dateien“ wie PDFs, Scans und E-Mails entwickelt. Sie suchen nicht nach <div>-Tags, sondern nutzen OCR und visuelle Analyse, um das Layout eines Dokuments zu erfassen.
Kann ich mit Mindee komplexe Tabellen aus gescannten PDFs extrahieren?
Ja, mit Mindee können Sie diese Funktion testen, indem Sie sich hier kostenlos registrieren und eine Beispieldatei hochladen. Die Erkennung von Einzelposten und komplexen Tabellen wird sowohl bei PDFs als auch bei allen gängigen Bildformaten vollständig unterstützt.
Genau hier stoßen allgemeine APIs oft an ihre Grenzen; herkömmliche OCR liefert häufig nur ein „Wort-Wirrwarr“.
Für komplexe Tabellen (mit mehrzeiligen Zeilen, verbundenen Zellen oder verschachtelten Kopfzeilen) benötigen Sie eine Pipeline mit visueller Intelligenz.
Profi-Tipp: Allgemeine LLMs halluzinieren bei Tabellenstrukturen oft. Achten Sie bei „unordentlichen“ Finanzdokumenten auf APIs, die auf spezifische Vision-Modelle setzen, anstatt lediglich generische Text-zu-Text-Modelle zu verwenden.
Wie extrahiere ich PDFs über 10 MB oder lange Dokumente ?
Mit Mindee können Sie Dateien mit einer Größe von bis zu 100 MB und einem Umfang von bis zu 200 Seiten verarbeiten.
Große Dateien (z. B. Hypothekenunterlagen mit 100 Seiten) sollten niemals in einer synchronen „Request-Response“ - Schleife verarbeitet werden. Hierbei kommen zwei API-Methoden infrage:
- Asynchrone Verarbeitung (Polling): Sie übermitteln die Datei, erhalten eine `job_id`, und die API verarbeitet den Vorgang im Hintergrund.
- Webhooks: Nach Abschluss der Verarbeitung sendet die API eine Benachrichtigung (einen „Ping“) mit den strukturierten JSON-Daten an Ihren Server. Dies gilt als Goldstandard für die Einrichtung von APIs zur automatisierten Datenextraktion, unabhängig von der verwendeten Programmiersprache (Python, Node.js, Java usw.).
Wie genau sind komplexe Tabellen und Positionsdaten bei verschiedenen Layouts?
Mindee könnte die ideale Lösung für Sie sein, wenn Sie eine zuverlässige API benötigen, um einzelne Rechnungspositionen (Line Items) mit hoher Genauigkeit zu extrahieren.
Die Genauigkeit variiert stark je nach Layout. Während „Schlüssel-Wert-Paare“ (wie Gesamtbetrag oder Datum) einfach zu erfassen sind, stellen Rechnungspositionen (Beschreibung, Menge, Einzelpreis) die größte Herausforderung dar, da jeder Anbieter einen anderen Tabellenstil verwendet
Benchmark-Tipp: Verlassen Sie sich nicht blind auf Marketing-Versprechen von „99 % Genauigkeit“. Testen Sie denselben Satz aus 50 „komplizierten“ Rechnungen bei verschiedenen Anbietern, um zu sehen, wer Positionen übersieht oder die „Menge“ mit dem „Steuersatz“ verwechselt.
Wie garantiere ich ein gültiges, strukturiertes JSON-Format?
Der erste Schritt ist der Erhalt von JSON; der zweite Schritt besteht darin, sicherzustellen, dass es sich um gültiges JSON handelt. Bei den meisten modernen APIs, wie etwa Mindee, lässt sich ein Datenschema definieren.
- Um einen Absturz Ihrer Datenbank zu verhindern, sollten Sie Pydantic (für Python) oder Zod (für TypeScript) verwenden, um die API-Ausgabe zu validieren.
- Entspricht die Extraktion nicht dem Schema (z. B. fehlt eine obligatorische `invoice_id`), sollte der Datensatz für eine manuelle Überprüfung markiert werden.
Wie sieht es mit der Datenextraktion aus handschriftlichen oder mehrsprachigen Dokumenten aus?
Mindee unterstützt alle Schriftsysteme und Sprachen sowie sämtliche handschriftlichen, für Menschen lesbaren Dokumente. Die meisten führenden APIs unterstützen mittlerweile Handschriften und über 100 Sprachen. Bei kursiver Handschrift ist jedoch im Vergleich zu gedrucktem Text mit einem Rückgang der Konfidenzwerte um 15–20 % zu rechnen. Prüfen Sie bei Nischensprachen, ob die OCR-Engine den jeweiligen Zeichensatz (z. B. kyrillisch oder arabisch) unterstützt.
Was sind konkrete Beispiele für die automatisierte Dokumentendatenextraktion?
Im Bereich der automatisierten Datenextraktion aus Dokumenten gibt es einige besonders wirkungsvolle Praxisbeispiele dafür, wie diese Technologie manuelle Dateneingaben überflüssig macht:
In der Kreditorenbuchhaltung ist die Datenextraktion der Motor hinter der „berührungslosen Rechnungsbearbeitung“ (Touchless Invoicing). Wenn ein Lieferant eine Rechnung sendet, liest die API nicht nur den Text, sondern extrahiert gezielt Felder wie Rechnungsnummer, Steuernummer, Nettobetrag und Gesamtsumme. Vor allem aber analysiert sie komplexe Positionstabellen und erfasst dabei jedes einzelne Produkt, die Menge sowie den Einzelpreis.
Dies ermöglicht dem System eine automatische Zahlungsabwicklung und stellt gleichzeitig sicher, dass Gutschriften und Kontoauszüge zu 100 % genau erfasst werden.
Zudem ist sie ein wesentlicher Bestandteil des Abgleichs von Bestellungen und Lieferungen (Matching & Reconciliation) im Supply-Chain-Management. Durch das Extrahieren der Bestellnummer aus dem Auftrag und der Artikelnummernliste (SKU-Liste) aus dem zugehörigen Lieferschein können Unternehmen automatisch prüfen, ob die gelieferten Artikel mit den bestellten übereinstimmen. Diese automatisierte Extraktion liefert Prüfern einen sauberen digitalen Nachweis über den Abgleich von Soll- und Ist-Zustand, ohne dass ein Mitarbeiter jemals Papierunterlagen manuell vergleichen muss.
Auch beim Kunden-Onboarding verwandelt die automatisierte Extraktion einen langsamen, manuellen Verifizierungsprozess in eine sofortige Überprüfung. Lädt ein Nutzer seinen Ausweis oder eine Versorgerrechnung hoch, extrahiert die API den vollständigen Namen, das Geburtsdatum und das Ablaufdatum des Dokuments. Zudem werden Adresse und Kundennummer aus Versorgerrechnungen ausgelesen, um einen sofortigen Wohnsitznachweis zu erbringen. So können Unternehmen die Identität eines Kunden in Sekundenschnelle verifizieren, was die Abbruchquoten während des Registrierungsprozesses erheblich senkt.
Weitere Praxisbeispiele für den Einsatz dieser Technologie durch Unternehmen finden Sie in unseren Kundenberichten.
